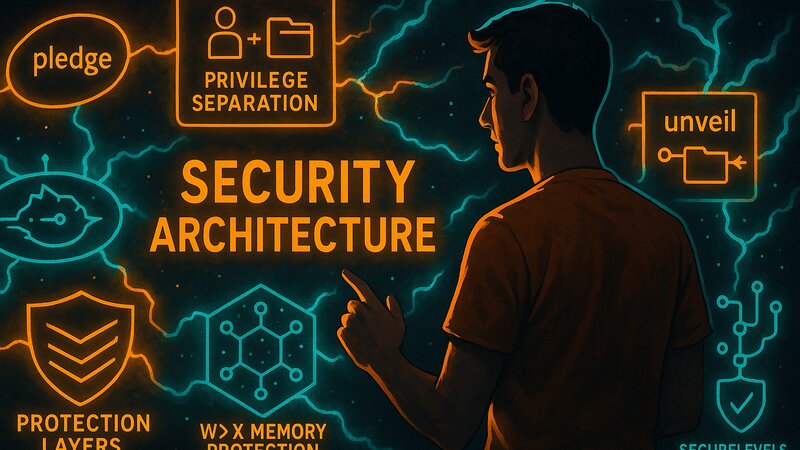
OpenBSD entwickelt Sicherheit durch Designentscheidungen im Kernel und Userland-Code. Privilege Separation ist ein verbreitetes Muster: Viele Daemons verteilen Aufgaben auf Prozesse mit unterschiedlichen Rechten. Die Systemcalls pledge() und unveil() beschränken Programme auf definierte Operationen und Dateizugriffe. W^X verhindert, dass Speicherbereiche gleichzeitig beschreibbar und ausführbar sind. Der Kernel bietet Sicherheitsstufen, die selbst Root-Zugriff einschränken.
Systemkonfiguration zeigt doas als Rechteeskalations-Tool und sysctl für Kernel-Parameter. Paketverwaltung erklärt Paket-Signaturen mit signify(1).
Secure by Default – Designphilosophie
OpenBSD startet nach einer Standardinstallation nur wenige Netzwerkdienste. SSH kann bereits während der Installation aktiviert werden; cron gehört zum normalen Systembetrieb. Andere Base-Daemons werden bei Bedarf über die rc-Konfiguration aktiviert. pf ist standardmäßig aktiviert und lädt beim Boot /etc/pf.conf. Welche Verbindungen erlaubt oder blockiert werden, bestimmt das geladene Ruleset – eine Default-Deny-Policy entsteht erst durch entsprechende Filterregeln.
Das Projekt führt kontinuierliche und wiederholte Code-Audits durch und sucht dabei gezielt nach Fehlerklassen wie Buffer Overflows, Format-String-Bugs und Race Conditions. Je nach Befund wird Code korrigiert, entfernt oder neu geschrieben. Die Entwickler bevorzugen überschaubare, überprüfbare Implementierungen gegenüber unnötiger Komplexität.
Diese Philosophie zeigt sich auch in eigenen Base-System-Komponenten. LibreSSL entstand 2014 als Fork von OpenSSL nach der durch Heartbleed ausgelösten Überprüfung der Codebasis. doas ersetzte sudo im Base-System. Nach Apache und zeitweise nginx entwickelte OpenBSD mit httpd einen eigenen Webserver mit bewusst begrenztem Funktionsumfang. Eine kleinere und klarer abgegrenzte Codebasis erleichtert Audits und Wartung.
Privilege Separation – Prozessisolation
Viele OpenBSD-Daemons teilen Aufgaben auf mehrere Prozesse mit unterschiedlichen Privilegien auf. Privilegierte Prozesse behalten nur Operationen, für die erhöhte Rechte erforderlich sind – etwa das Binden privilegierter Ports oder das Öffnen geschützter Dateien. Andere Aufgaben laufen in Prozessen mit geringeren Rechten.
Der SSH-Daemon sshd demonstriert dieses Prinzip. Listener, Authentifizierung, privilegierte Session-Vorbereitung und die eigentliche Benutzersession werden auf unterschiedliche Prozesse beziehungsweise Komponenten verteilt. Nach erfolgreicher Anmeldung läuft die eigentliche Session mit den Rechten des authentifizierten Benutzers. Eine Kompromittierung dieser Session verschafft damit zunächst dessen Benutzerrechte statt unmittelbar Root-Rechte.
$ ps aux | grep sshd
root     48124  0.0  0.2  1104  2492 ??  S       8:16AM    0:00.05 sshd: /usr/sbin/sshd [listener] 0 of 10-100 startups (sshd)
root     75300  0.0  0.4  1596  3928 ??  S       8:22AM    0:00.11 sshd-session: michael [priv] (sshd-session)
michael   9433  0.0  0.4  1880  3628 ??  S       8:23AM    0:00.04 sshd-session: michael@ttyp0 (sshd-session)
Der Listener-Prozess ([listener]) läuft als Root und wartet auf eingehende Verbindungen. Die Angabe 0 of 10-100 startups gehört zur MaxStartups-Begrenzung gleichzeitig noch nicht authentifizierter SSH-Verbindungen; sie zählt nicht die laufenden Benutzersessions. Nach erfolgreicher Authentifizierung bereitet ein privilegierter Session-Prozess (sshd-session: michael [priv]) den Benutzerkontext vor. Der eigentliche Session-Prozess (sshd-session: michael@ttyp0) läuft anschließend als angemeldeter Benutzer.
Auch httpd nutzt Prozess- und Privilegientrennung. Privilegierte Aufgaben bleiben von der eigentlichen Verarbeitung getrennt; Worker laufen mit eingeschränkten Rechten. CGI-Programme können über den separaten FastCGI-Server slowcgi ausgeführt werden. Diese Architektur reduziert die privilegierte Angriffsfläche: Eine Kompromittierung eines unprivilegierten Workers verschafft zunächst dessen Rechte; für Root-Rechte wäre eine zusätzliche Privilege Escalation erforderlich. Die beteiligten Prozesse kommunizieren über definierte IPC-Schnittstellen.
pledge() – Systemcall-Beschränkung
Der Systemcall pledge() reduziert verfügbare Kernel-Operationen auf eine definierte Menge. Programme deklarieren welche Funktionen sie benötigen. Der Kernel verweigert alle anderen Systemcalls und beendet den Prozess mit SIGABRT bei Verstößen.
Die Syntax definiert erlaubte Operationen als String:
if (pledge("stdio rpath inet dns", NULL) == -1)
    err(1, "pledge");
Dieser Aufruf erlaubt Standard-I/O (stdio), lesenden Dateizugriff (rpath), Netzwerk-Operationen (inet) und DNS-Auflösung (dns). Alle anderen Systemcalls sind verboten – das Programm kann keine Dateien schreiben, keine neuen Prozesse starten, keine Geräte öffnen.
Die wichtigsten Promises:
- stdio – Standard-I/O, Speicherallokation, Signale
- rpath – Lesender Dateizugriff
- wpath – Schreibender Dateizugriff
- cpath – Dateien erstellen und entfernen
- inet – IPv4/IPv6-Sockets
- unix – Unix-Domain-Sockets für IPC
- dns – DNS-Auflösung
- proc – Prozess-Operationen (fork, kill)
- exec – Programme ausführen
- prot_exec –
PROT_EXECfürmmap()undmprotect()
Die Promise-Liste entwickelt sich mit jeder OpenBSD-Version weiter. In OpenBSD 7.8 existierte tmppath für temporäre Dateien in /tmp — seit 7.9 ist diese Promise entfernt und gibt EINVAL zurück. Ersatz ist "rpath wpath cpath" kombiniert mit unveil("/tmp", "rwc"). Die vollständige und versionsgenaue Liste liefert:
$ man 2 pledge
Der HTTP-Server httpd nutzt pledge() systematisch. Nach dem Initialisieren und Binden der Ports beschränkt sich der Worker-Prozess:
pledge("stdio rpath inet", NULL);
Worker können Dateien lesen und Netzwerk-Verbindungen bedienen – mehr nicht. Keine Dateien schreiben, keine neuen Prozesse starten, keine Kernel-Parameter ändern.
pledge() wirkt irreversibel. Nach dem Aufruf kann das Programm die Beschränkungen nicht aufheben. Nur strengere Promises sind möglich durch erneuten pledge()-Aufruf mit weniger Rechten.
Die meisten Base-System-Programme nutzen pledge(). Der Befehl ls benötigt nur stdio und rpath. Der Editor vi braucht zusätzlich wpath und cpath für Dateiänderungen. SSH-Clients verwenden stdio inet dns tty proc exec für Terminal-Interaktion und Remote-Befehle.
unveil() – Dateisystem-Beschränkung
Der Systemcall unveil() beschränkt Dateisystem-Zugriff auf explizit freigegebene Pfade. Der erste Aufruf entfernt die Sichtbarkeit des gesamten Dateisystems — nur der angegebene Pfad mit den definierten Rechten bleibt zugänglich. Weitere Aufrufe können zusätzliche Pfade freigeben.
Die Syntax definiert Pfad und Zugriffsrechte:
if (unveil("/etc/httpd.conf", "r") == -1)
    err(1, "unveil");
if (unveil("/var/www", "r") == -1)
    err(1, "unveil");
if (unveil(NULL, NULL) == -1)
    err(1, "unveil");
Dieser Code erlaubt lesenden Zugriff auf /etc/httpd.conf und /var/www. Der finale unveil(NULL, NULL)-Aufruf deaktiviert weitere unveil()-Aufrufe — die Konfiguration ist eingefroren. Zugriffe auf nicht freigegebene Pfade schlagen fehl: EACCES wenn die Permission nicht passt, ENOENT wenn kein unveil() für den Pfad qualifiziert.
Die verfügbaren Rechte:
- r – Lesen
- w – Schreiben
- x – Ausführen
- c – Erstellen und Entfernen
Der Mail-Transfer-Agent smtpd nutzt unveil() für verschiedene Prozesse. Der Netzwerk-Listener braucht nur Konfigurationsdateien:
unveil("/etc/mail/smtpd.conf", "r");
unveil("/etc/ssl/", "r");
unveil(NULL, NULL);
Der Queue-Manager benötigt Schreibzugriff auf das Spool-Verzeichnis:
unveil("/var/spool/smtpd/", "rwc");
unveil(NULL, NULL);
Ein kompromittierter Prozess sieht nur die Pfade und Zugriffsarten, die ihm über unveil() freigegeben wurden.
unveil(NULL, NULL) sind weitere unveil()-Aufrufe nicht mehr möglich. OpenBSD 7.9 empfiehlt ausdrücklich, unveil() nach der Konfiguration zu sperren — ein Programm das seine Dateisystem-Sicht offen lässt gibt unnötig Angriffsfläche frei.
unveil() kombiniert mit pledge() ergibt eine mehrschichtige Beschränkung. pledge("stdio rpath") begrenzt die verfügbaren Operationen, unveil() zusätzlich den sichtbaren und zugänglichen Teil des Dateisystems. Beide Mechanismen ergänzen sich, ohne einen externen Sandbox-Daemon zu benötigen.
Securelevels – Kernel-Sicherheitsstufen
OpenBSD implementiert Kernel-Sicherheitsstufen, die selbst Root-Zugriff einschränken. Securelevels begrenzen besonders kritische Eingriffe während des Betriebs. Während des Bootstrappings und im Single-User-Mode befindet sich das System normalerweise auf Securelevel 0. Beim Übergang in den Multi-User-Betrieb wird der Securelevel auf 1 angehoben. Securelevel -1 ist ein Sonderfall, bei dem diese automatische Anhebung unterbleibt.
Die Stufen definieren zunehmende Beschränkungen:
Securelevel -1: Permanently Insecure – funktional wie Securelevel 0, aber init(8) erhöht den Securelevel nicht automatisch.
Securelevel 0: Insecure – wird beim Bootstrapping und im Single-User-Mode genutzt. Alle Geräte sind les- und schreibbar, System-File-Flags können gelöscht werden.
Securelevel 1: Secure – Standard im Mehrbenutzerbetrieb. Verhindert:
- Öffnen von
/dev/memund/dev/kmem - Schreibzugriff auf Raw-Disk-Devices gemounteter Dateisysteme
- Entfernen von System-Immutable- und System-Append-only-File-Flags
- Änderungen an sicherheitsrelevanten
sysctl-Variablen (hw.allowpowerdown,kern.allowkmem,kern.utc_offset) - Erhöhen der
ddb.consoleundddb.panicsysctl-Variablen gpioctlkann nur auf beim Boot konfigurierte GPIO-Pins zugreifen
Securelevel 2: Highly Secure – alle Einschränkungen von Stufe 1, zusätzlich:
- Raw-Disk-Devices sind immer schreibgeschützt — auch wenn nicht gemountet
- Systemzeit kann nicht zurückgestellt oder nahe an einen Überlauf gesetzt werden
pf-Filter- und NAT-Regeln sind vollständig unveränderlich
Das aktuelle Securelevel zeigt sysctl:
$ sysctl kern.securelevel
kern.securelevel=1
Im normalen Multi-User-Betrieb liegt der Securelevel bei 1:
$ doas sysctl kern.securelevel=1
kern.securelevel: 1 -> 1
init(8) — nicht Root, nicht doas. Eine laufende Senkung ist nicht möglich. Für Wartungsaufgaben die niedrigere Securelevels erfordern: im Single-User-Mode arbeiten.
Root kann den Securelevel erhöhen. Ab Securelevel 1 kann er nicht mehr auf einen niedrigeren Wert zurückgesetzt werden; das Senken ist init(8) vorbehalten. Securelevel 1 schränkt unter anderem den Zugriff auf Kernel-Speicher ein; Securelevel 2 verhindert zusätzlich Änderungen an pf-Filter- und NAT-Regeln. Veränderbare PF-Tabelleninhalte sind davon nicht automatisch umfasst.
/etc/rc.securelevel enthält Befehle die ausgeführt werden bevor rc(8) den Securelevel erhöht — etwa um File-Flags zu setzen oder Kernel-Parameter anzupassen die danach unveränderlich wären.
Da der Securelevel über den in-kernel Debugger ddb(4) manipuliert werden kann, empfiehlt es sich auf produktiven Systemen den Debugger zu deaktivieren:
$ sysctl ddb.console
ddb.console=0
$ sysctl ddb.panic
ddb.panic=1
$ doas sysctl ddb.panic=0
ddb.panic: 1 -> 0
$ doas sysctl ddb.panic=1
sysctl: ddb.panic: Operation not permitted
Ab Securelevel 1 können ddb.console und ddb.panic nicht mehr erhöht werden. Werden sie vorher auf 0 gesetzt, bleiben sie deshalb während des laufenden Multi-User-Betriebs deaktiviert.
W^X – Write XOR Execute Memory Protection
OpenBSD erzwingt W^X (Write XOR Execute): Speicher darf nicht gleichzeitig beschreibbar und ausführbar sein. Diese Trennung erschwert Code-Injection-Angriffe, bei denen Schadcode zunächst in beschreibbaren Speicher geschrieben und anschließend ausgeführt werden soll.
Code- und Datenbereiche erhalten dafür unterschiedliche Speicherrechte. Daten, Heap und Stack sind typischerweise les- und beschreibbar, aber nicht ausführbar. Codebereiche sind ausführbar und nicht beschreibbar; auf unterstützten Architekturen nutzt OpenBSD zusätzlich Execute-only-Schutz für Code. Execute-only ist eine zusätzliche Härtung und nicht mit W^X selbst gleichzusetzen.
Das mmap()-Systemcall erzwingt die Regel. Programme können Speicher nicht gleichzeitig als PROT_WRITE und PROT_EXEC markieren.
Beispiel (abgelehnt): PROT_WRITE|PROT_EXEC
void *mem = mmap(NULL, size, PROT_WRITE|PROT_EXEC,
                 MAP_ANON, -1, 0);
Rückgabe: MAP_FAILED, errno = ENOTSUP
Korrekt: erst schreiben, dann auf ausführbar umschalten
void *mem = mmap(NULL, size, PROT_READ|PROT_WRITE,
                 MAP_ANON, -1, 0);
write_code(mem);
mprotect(mem, size, PROT_READ|PROT_EXEC);
Diese Sequenz erlaubt Just-In-Time-Compiler oder Self-Modifying-Code unter kontrollierten Bedingungen. Nach mprotect() mit PROT_EXEC ist der Speicher nicht mehr beschreibbar.
PROT_WRITE|PROT_EXEC nutzen wenn zwei Bedingungen erfüllt sind: Das Dateisystem ist mit wxallowed gemountet und das Binary ist zur Link-Zeit mit wxneeded getaggt. Auf produktiven Servern ohne solche Programme ist diese Ausnahme nicht nötig.
Bei W^X-Problemen hilft kern.wxabort zur Diagnose:
$ sysctl kern.wxabort
kern.wxabort=0
Beim Standardwert 0 führt eine W^X-Verletzung zu einem Fehler. Mit kern.wxabort=1 erzeugt der Kernel stattdessen einen Abort, was die Diagnose problematischer Programme erleichtern kann:
$ doas sysctl kern.wxabort=1
kern.wxabort: 0 -> 1
OpenBSD wendet W^X sowohl im Userland als auch im Kernel an. Der Kernel selbst trennt ebenfalls beschreibbare und ausführbare Speicherbereiche.
Auf modernen Architekturen nutzt OpenBSD die vorhandenen Hardwaremechanismen für nicht ausführbare Speicherbereiche und ergänzt sie durch weitere Schutzmechanismen des Kernels und der virtuellen Speicherverwaltung.
Die Implementierung betrifft auch Stack-Schutz. Der Stack ist explizit nicht-ausführbar was Buffer-Overflow-Exploits erschwert. Angreifer können Stack-Daten überschreiben aber keinen Code dort platzieren und ausführen. Kombiniert mit Stack-Protector-Canaries ergibt das mehrschichtige Abwehr.
Kryptographie-Stack
OpenBSD integriert Kryptographie tief ins System. LibreSSL ersetzt OpenSSL als TLS-Bibliothek. Der Zufallsgenerator arc4random() liefert kryptographisch sichere Zufallszahlen ohne Seed-Management. Passwort-Hashing nutzt bcrypt mit anpassbarem Work-Factor.
LibreSSL – OpenSSL-Fork
Nach der Heartbleed-Schwachstelle 2014 begann OpenBSD mit einer umfassenden Überprüfung der OpenSSL-Codebasis und forkte OpenSSL 1.0.1g zu LibreSSL. In der frühen Bereinigung wurden mehr als 90.000 Zeilen C-Code entfernt, darunter nicht mehr benötigte Plattformunterstützung und historisch gewachsener Code. Ziel war eine kleinere, besser überprüfbare TLS- und Kryptographie-Codebasis.
LibreSSL ist Bestandteil des OpenBSD-Base-Systems und wird gemeinsam mit dem System gepflegt. Zusätzlich installierte Packages können LibreSSL verwenden, sind aber nicht grundsätzlich auf dieselbe TLS-Bibliothek festgelegt.
LibreSSL behielt viele OpenSSL-kompatible Schnittstellen bei, entfernte jedoch bewusst veraltete oder unerwünschte APIs und entwickelte sich seit dem Fork eigenständig weiter. OpenSSL-Kompatibilität ist deshalb keine allgemeine Garantie.
arc4random() – Kryptographischer PRNG
Die Funktion arc4random() generiert 32-Bit-Zufallszahlen ohne manuelles Seed-Management. Der Name lässt sich als “A Replacement Call for Random” lesen — historisch geht er auf den früher verwendeten ARC4/RC4-Generator zurück. Seit OpenBSD 5.5 verwendet die Implementierung ChaCha20. Der Generator wird regelmäßig aus dem Kernel-Random-Subsystem neu gespeist; nach fork(2) erfolgt ebenfalls ein Re-Seed, damit Parent und Child nicht einfach denselben übernommenen PRNG-Zustand weiterverwenden.
Zufallszahl zwischen 0 und 99:
uint32_t random = arc4random_uniform(100);
Zufälligen Buffer füllen — etwa für Schlüsselmaterial:
unsigned char key[32];
arc4random_buf(key, sizeof(key));
Zufallszahl zwischen min und max:
uint32_t random_range(uint32_t min, uint32_t max) {
    return min + arc4random_uniform(max - min + 1);
}
Die arc4random_uniform()-Funktion vermeidet Modulo-Bias. Naive Implementierungen mit arc4random() % n verteilen Zahlen ungleichmäßig bei nicht-Zweierpotenzen. LibC enthält eine optimierte Bias-freie Implementierung.
Der Kernel mischt Entropiematerial aus Systemaktivität und verfügbaren Hardware-Zufallsquellen ein. OpenBSD speichert außerdem Entropiematerial für den nächsten Boot und initialisiert damit den Zufallszahlengenerator früh im Startvorgang. /dev/random ist unter OpenBSD ein Alias für /dev/urandom; beide liefern nicht blockierend Daten aus demselben kryptographischen Generator. Auf anderen Betriebssystemen kann /dev/random eine andere Semantik besitzen.
bcrypt – Password Hashing
OpenBSD nutzt bcrypt für Passwort-Hashing. Der Algorithmus basiert auf Blowfish mit adaptivem Work-Factor — höhere Work-Factors bedeuten mehr CPU-Zeit pro Hash und erschweren Brute-Force-Angriffe auf gestohlene Passwort-Datenbanken.
Die Datei /etc/master.passwd speichert bcrypt-Hashes:
michael:$2b$10$TX6ZNHMmjVF8RiD9q2dfBOU0S5djznlXkxYSzuOj8cLzQ3n4t0RfS:1001:1001:...
Das Format: $2b$ markiert bcrypt. 10 ist der logarithmische Work-Factor und entspricht einem Kostenparameter von 2^10. Der folgende String enthält Salt und Hash in der bcrypt-Darstellung.
Der Befehl encrypt(1) generiert bcrypt-Hashes:
$ encrypt "testpassword"
$2b$10$TX6ZNHMmjVF8RiD9q2dfBOU0S5djznlXkxYSzuOj8cLzQ3n4t0RfS
OpenBSD kann den bcrypt-Work-Factor automatisch anhand der Systemleistung wählen. Für lokale Passwort-Hashes verwendet die Standardkonfiguration bcrypt,a; Programme können über crypt_newhash(3) auch einen festen bcrypt-Kostenparameter vorgeben.
crypt(3) ist deprecated. Neue Programme nutzen crypt_newhash(3) zum Erstellen und crypt_checkpass(3) zum Prüfen von Passwort-Hashes.
Weitere Sicherheitsfeatures
OpenBSD implementiert zusätzliche Schutzmechanismen die Exploit-Entwicklung erschweren. Address Space Layout Randomization (ASLR) verteilt Speicherbereiche zufällig. Stack-Protector-Canaries erkennen Buffer-Overflows. Return-Oriented-Programming (ROP) Gadgets werden durch Compiler-Optimierungen reduziert.
ASLR – Address Space Layout Randomization
ASLR randomisiert die Position wichtiger Bereiche des Prozessadressraums, darunter Stack, Heap, Libraries und das Hauptprogramm. Dadurch können Exploits nicht zuverlässig mit fest codierten Speicheradressen arbeiten. Beim Laden eines Programms über exec() entsteht ein neu randomisiertes Layout; ein reines fork() übernimmt dagegen zunächst den Adressraum des Parent-Prozesses.
OpenBSD aktiviert ASLR standardmäßig. Zusätzlich steuert library_aslr in /etc/rc.conf eine weitere ROP-Härtung beim Boot:
$ grep library_aslr /etc/rc.conf
library_aslr=YES		# set to NO to disable library randomization
PIE ist im OpenBSD-Compiler standardmäßig aktiviert. Dadurch können ausführbare Programme beim Laden an wechselnden Basisadressen platziert werden. Einzelne Builds können PIE bei Bedarf explizit deaktivieren.
Stack Protector und RETGUARD
Der klassische Stack Protector erkennt bestimmte Stack-Buffer-Overflows über Canary-Werte. OpenBSD verwendet auf unterstützten Architekturen zusätzlich beziehungsweise anstelle dieses Mechanismus RETGUARD. RETGUARD schützt gezielt die Return-Adresse einer Funktion mit einem funktionsspezifischen zufälligen Cookie.
Vor dem Function-Return wird geprüft, ob die gespeicherte Return-Adresse noch zum Cookie passt. Eine Manipulation der Return-Adresse führt zum Abbruch des Programms. Anders als ein klassischer Stack-Canary prüft RETGUARD damit die Return-Adresse direkt.
void test(char *input) {
    char buffer[64];
    strncpy(buffer, input, sizeof(buffer)-1);
    printf("%s\n", buffer);
}
Auf einer von RETGUARD unterstützten Architektur kann der Compiler die Funktion entsprechend instrumentieren. Ein Blick in das kompilierte Binary zeigt die erzeugten RETGUARD-Cookies:
$ cc -g -o test test.c
$ nm test | grep retguard
00002bc0 r __retguard_1205
00002bd8 r __retguard_1471
00002be0 r __retguard_1773
00002be8 r __retguard_2333
00002bd0 r __retguard_2473
00002bf0 r __retguard_2997
Die __retguard_*-Symbole zeigen die vom Compiler erzeugten RETGUARD-Cookies. Die Zufallswerte liegen in der ELF-Sektion .openbsd.randomdata und werden beim Laden des Programms initialisiert.
RETGUARD ist architekturspezifisch. In OpenBSD 7.8 und 7.9 wird der Mechanismus unter anderem auf amd64 und arm64 sowie auf weiteren unterstützten Architekturen eingesetzt. Er ist damit kein universelles Merkmal jedes OpenBSD-Binaries auf jeder Plattform.
ROP-Mitigation
Return-Oriented-Programming (ROP) nutzt existierende Code-Schnipsel (Gadgets) für Exploits. W^X verhindert neue Code-Injection — ROP umgeht das durch Verketten vorhandener Instruktionen.
OpenBSD erschwert ROP durch mehrere Maßnahmen:
Library-Randomization: Bei library_aslr=YES ordnet OpenBSD beim Boot bestimmte Systembibliotheken neu an. Dabei werden unter anderem Objektdateien in zufälliger Reihenfolge neu gelinkt. Dadurch ändern sich auch interne Adressen und für ROP interessante Codepositionen zwischen Systemstarts.
Return Address Protection: RETGUARD schützt auf unterstützten Architekturen Return-Adressen instrumentierter Funktionen mit funktionsspezifischen zufälligen Cookies.
W^X: Speicher darf nicht gleichzeitig beschreibbar und ausführbar sein. Das erschwert die direkte Ausführung neu injizierten Codes.
Zusätzlich reduziert der OpenBSD-Compiler auf unterstützten Architekturen bestimmte für ROP geeignete Instruktionsfolgen. Kein einzelner Mechanismus ist unüberwindbar — zusammen erhöhen sie den Aufwand für erfolgreiche Exploits erheblich.
Sicherheit durch Einfachheit
Die beschriebenen Mechanismen greifen an unterschiedlichen Stellen des Systems. Privilege Separation verteilt Aufgaben und Rechte, pledge() und unveil() begrenzen die Möglichkeiten laufender Prozesse, Securelevels schränken Eingriffe in das laufende System ein und die Exploit-Mitigationen erschweren die Ausnutzung von Speicherfehlern.
OpenBSD setzt dabei nicht auf einen einzelnen Schutzmechanismus. Mehrere voneinander unabhängige Grenzen sollen verhindern, dass ein Fehler oder eine kompromittierte Komponente ohne weitere Hürden das gesamte System betrifft. Überschaubare Komponenten und kontinuierliche Code-Audits ergänzen diese technischen Grenzen bereits bei der Entwicklung des Systems.
Der Artikel OpenBSD: Netzwerk und Routing behandelt Netzwerk-Konfiguration und Routing für produktive OpenBSD-Systeme. OpenBSD: Firewall und pf – Grundlagen & Syntax erklärt die Packet-Filter-Firewall und das Policy-Design.
Verwendete Software und Versionen
Diese Anleitung bezieht sich auf:
- OpenBSD: 7.8, 7.9
- Kontext: Server und Desktop
- Stand: Juni 2026